
Lambda сообщила 13 октября 2026 года, что совместно с NVIDIA сделает открытый GPU-планировщик Run: ai штатной управляемой опцией сервиса Lambda Kubernetes Service. Компания поддерживает Run: ai на своей инфраструктуре с 2022 года и теперь намерена упаковывать, проверять и эксплуатировать его внутри LKS. Для команд, арендующих GPU-мощности, это важно, поскольку совместное использование, квоты и обработка сбоев станут поддерживаемыми компонентами, а не ручной настройкой.
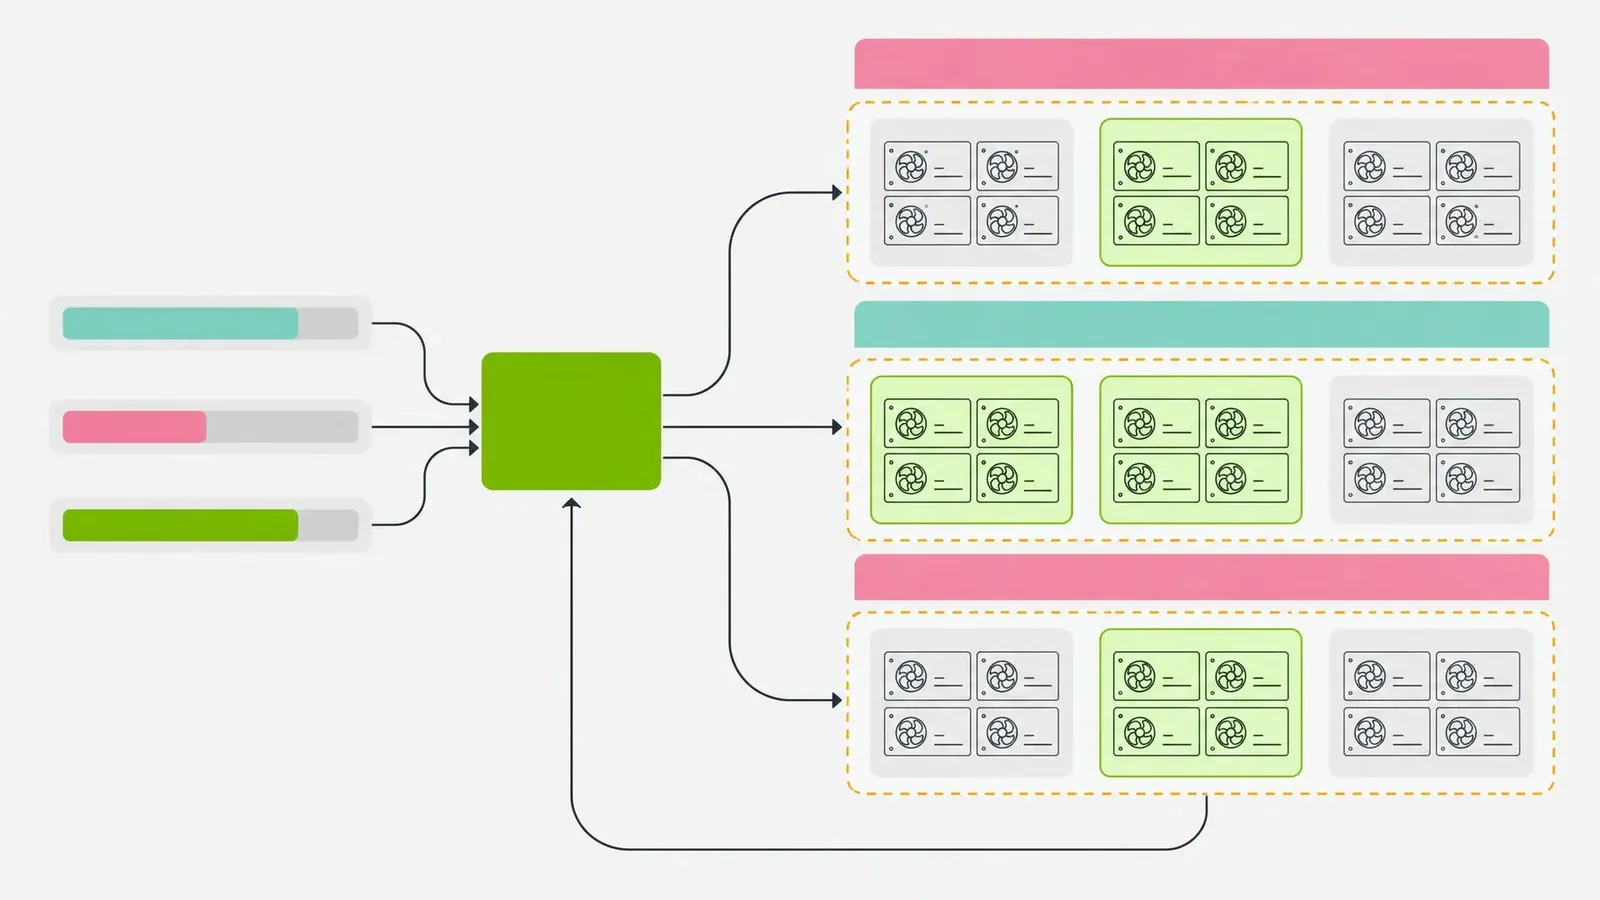
Как работают совместное использование и квоты Run: ai
Детали приведены в записи блога Lambda от 13 октября 2026 года, где компания приветствовала решение NVIDIA открыть код Run: ai. Lambda описала планируемую библиотеку планировщиков в виде управляемых компонентов, включая планировщики для Kubernetes, Slurm и Run: ai. NVIDIA объявила об открытии кода KAI Scheduler, изначально созданного внутри платформы Run: ai, под лицензией Apache 2.0 еще 1 апреля 2025 года. При этом NVIDIA отметила, что планировщик по-прежнему поставляется в составе платформы NVIDIA Run: ai.
По описанию Lambda, Run: ai расширяет стандартный планировщик Kubernetes двумя функциями: совместным использованием GPU, когда несколько нагрузок работают на одном ускорителе, и планированием по квотам, когда у каждой команды есть гарантированный лимит с возможностью занимать простаивающие мощности. В документации NVIDIA о долях GPU сказано, что память делится на части с контролируемым размером запроса, а каждый под получает отдельное виртуальное адресное пространство, так называемый "logical GPU". Вычисления делятся по умолчанию через time-slicing, а вариант на несколько GPU позволяет выделить 8x40GB на восьми ускорителях, оставив по 40GB на каждом для других задач. Доли GPU и режим Multi-Instance GPU нельзя использовать на одном узле.
Цикл планирования делает снимок кластера, рассчитывает справедливую долю каждой очереди на этапах deserved-quota и over-quota, затем выполняет действия allocate, consolidation, reclaim и preempt. Каждый новый под включается в группу подов, а групповое планирование означает, что многоподовая нагрузка либо размещается целиком, либо полностью ожидает. Очередь создается для каждого проекта и департамента в пуле узлов, гарантированные квоты ограничивают непрерываемые нагрузки, а сверхквотные ресурсы доступны только прерываемым задачам. Встроенный podgrouper связывает нагрузки с Kubeflow, Ray, Argo и Training Operator, а администраторы задают стратегии bin-pack или spread для каждого пула узлов.
Что это меняет для покупателей ИИ-инфраструктуры
Для компаний, обучающих и проверяющих модели на общих кластерах, практический эффект состоит в росте загрузки без ручного согласования простаивающих GPU. Отладка, которой нужна часть одного ускорителя, проверки с множеством независимых заданий и распределенное обучение с большим числом связанных GPU смогут работать вместе при гарантированных квотах и заимствовании. Небольшие команды получат предсказуемый доступ и шанс использовать свободные мощности, а крупные организации — квоты уровня департаментов и перераспределение при отклонении от справедливой доли. Общее хранилище, поддержка GPU и InfiniBand RDMA, а также предустановленные NVIDIA GPU и Network Operator в кластерах 1-Click Cluster сокращают объем сборки.
Ограничения связаны со состоянием оборудования, выбором размещения и ответственностью за эксплуатацию. Lambda отметила, что совместное использование и вытеснение предполагают исправный GPU, хотя ускорители выдают ошибки XID, связи NVLink и PCIe деградируют, строки памяти переназначаются, а порты InfiniBand снижают скорость. В LKS уже работает автоматическое восстановление: сбои показываются как состояния узлов Kubernetes, узел закрывается для новых задач, задания переносятся, а возврат возможен только после повторной проверки или ремонта. Покупателям нужно уточнить проверяемую версию планировщика, маркировку прерываемых заданий, стратегию размещения для пула и совместимость узлов с долями или MIG.
Индикатором станет готовая интеграция, при которой Lambda возьмет на себя упаковку, проверку и текущую эксплуатацию Run: ai внутри LKS. Ее появление покажет, что открытая лицензия превращается в поддерживаемую библиотеку планировщиков, а не в набор инструкций по интеграции. Если следующие выпуски будут поддерживать компонент в актуальном виде под оборудование Lambda, закупка оркестрации GPU сместится от ручной сборки к выбору поддерживаемой опции.
