
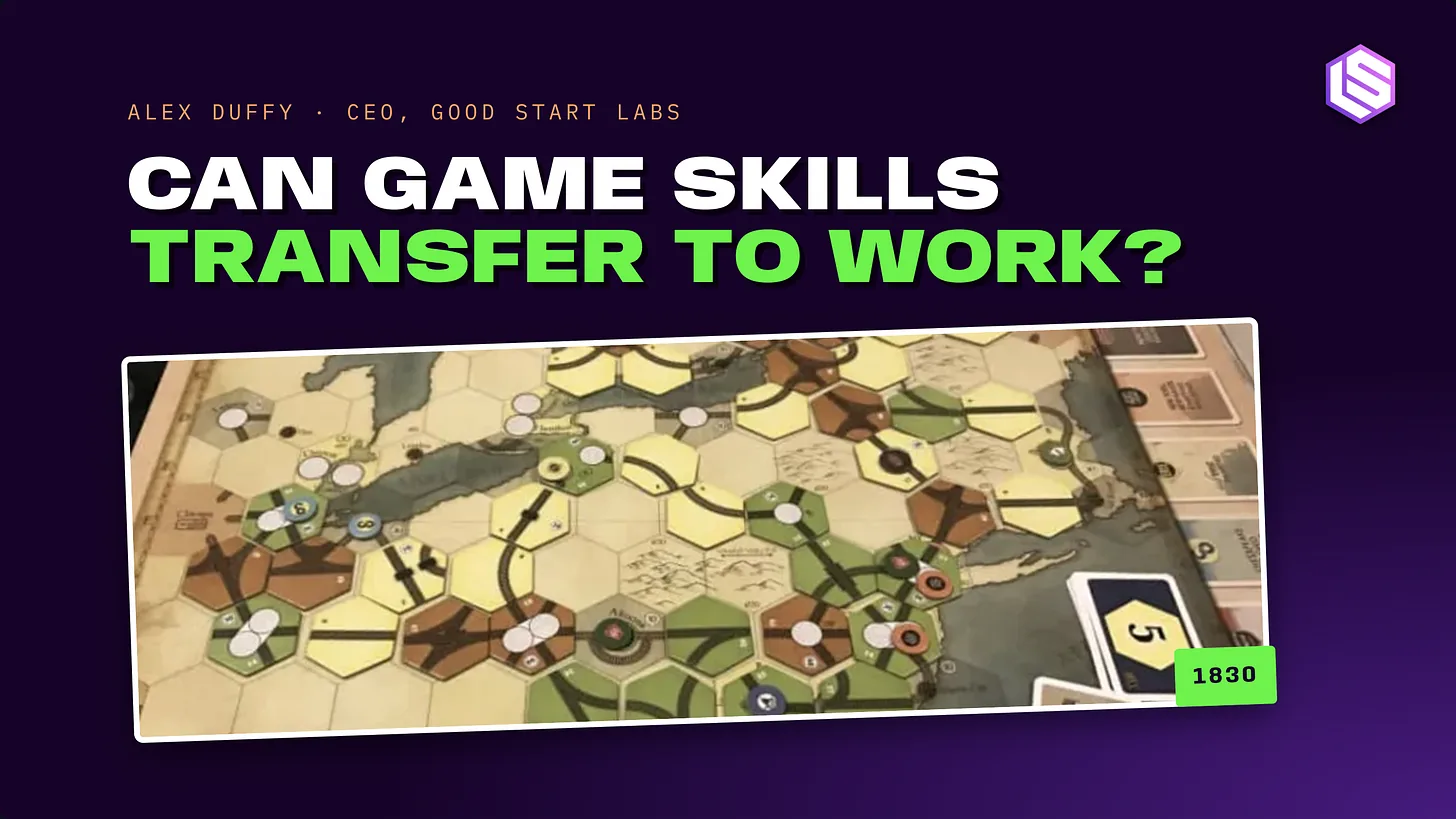
Good Start Labs обучила модель на 30B параметров внутри настольной игры 1830: The Game of Railroads and Robber Barons, а затем проверила её на задачах финансового исследования. Только один из двух вариантов обучения улучшил результат модели на бенчмарке Finance-Agent, хотя оба улучшили игру внутри самой игры. Результат важен потому, что показывает: какие навыки переносятся в работу, решает способ обучения ИИ на игре, а не сама игра.
Что показал эксперимент с 1830
Компания сравнила два подхода. В первом модель получала одно состояние игры и должна была назвать следующий ход. Во втором, описанном как multi-turn terminal agent, модель использовала инструменты, чтобы исследовать среду, планировать стратегию и адаптироваться в реальном времени. Оба варианта повысили игровые показатели, но только версия с terminal agent улучшила результат на Finance-Agent. В самой игре есть механизм фондового рынка: игроки торгуют акциями железнодорожных компаний, чтобы построить логистическую сеть. Good Start Labs составила задания, в которых модель ищет в базе данные о том, как проходили партии, переносит их в файл Excel, рассуждает над ними, создаёт внутри файла функции и вычисляет ответ там же. По словам соучредителя и CEO Алекса Даффи, это повторяет типичный финансовый рабочий процесс, только выполняется внутри игры.
Решающей частью оказался harness — программный слой, который подаёт игру модели. Даффи говорит, что к одной и той же игре можно подойти по-разному, и от устройства этого слоя зависит, чему модель научится. Модель, смотрящая на картинки, выучит не то же самое, что модель, читающая обычный текст, и обе отличаются от той, у которой всё представлено в виде Python. Good Start Labs может также добавить экспертную модель, дающую более плотные пошаговые награды вместо одного сигнала победы или поражения. Заявленная цель компании — понять, как проектировать среду обучения под конкретные способности. Тот же вопрос разбирается в статье COS-PLAY, которую Даффи и соучредитель Тайлер Маркес написали с исследователями из нескольких университетов: там агент принятия решений опирается на обучаемый банк навыков, а отдельный агент изучает траекторию и обновляет этот банк для следующего запуска.
Что это значит для компаний, покупающих обучение ИИ
Good Start Labs продаёт данные и среды обучения, а не готовые приложения. Основные заказчики — frontier-лаборатории, которые покупают данные для reinforcement learning, чтобы дообучать свои модели. Данные бывают двух видов: траектории агентов, играющих в игры, где записано, что агент наблюдал, решил, сделал и что за этим последовало, и заказные данные для издателей игр, в чьих проектах работают живые агенты. Даффи говорит, что любые данные, продаваемые разработчикам моделей, обезличиваются и очищаются от персональных данных. Среды обучения — это полные игры, которые модели проходят от начала до конца, и дело не в победе, а в решении задач, включая такие, где игровой движок служит проверяемым источником наград, а модель действует неожиданным образом.
История компании началась с трансляции на Twitch в 2025 году, где frontier-модели играли в Diplomacy — игру, которая, по словам Даффи, обычно занимает дни или недели. Наблюдая за ней, он заметил, что модель OpenAI o3 побеждала, планируя будущее предательство, а Claude Opus 4 отказывалась лгать и, по его выражению, была разгромлена. Этот контраст навёл на мысль, что игры с проверяемым исходом могут учить стратегическому мышлению. В более поздней статье на Every Даффи написал, что дообучение модели на Diplomacy улучшило её результаты на бенчмарках customer support и industrial operations. Good Start Labs была выделена из медиа- и инструментальной компании Every в октябре, получив $3,6 млн от General Catalyst, Inovia, Every и бизнес-ангелов. Даффи работал в Every руководителем направления обучения ИИ.
Практическое следствие для компаний, внедряющих ИИ, в том, что среда обучения становится покупаемым активом, отдельным от самой модели. Бизнесу, которому нужно, чтобы агент следовал фиксированной процедуре — например, вытаскивал цифры из базы в таблицу и считал результат, — теперь можно купить среду, построенную вокруг этой процедуры, вместо того чтобы полагаться на инструкции в промпте. Случай с 1830 показывает, что выигрыш проявляется в многошаговом использовании инструментов, а не в одиночных ответах. Для небольшой компании это в основном выбор поставщика, чья среда совпадает с её рабочим процессом; для крупной — решение, покупать такие среды или строить их внутри, поскольку именно harness, а не базовая модель, задаёт поведение.
Чего результат не устанавливает — насколько далеко простирается перенос. Даффи говорит, что сегодняшние данные ясно подтверждают: целенаправленное выполнение задач важно, а рассуждения переносятся. Он ссылается на недавнюю статью Surge AI о том, что дообучение на офисной работе улучшило написание кода, и отмечает, что DeepSeek R1 показал это шире. Он также говорит, что компания видела это дважды сама: в финансовой задаче на 1830 и в обучении на Diplomacy, которое дало лучшего агента поддержки клиентов, а каждая построенная ею среда улучшает использование инструментов дальше по цепочке. Однако более широкий и надёжный перенос остаётся открытым вопросом. Покупателям стоит спросить, какой бенчмарк использовался, совпадает ли структура задачи с их собственной и сохраняется ли улучшение на моделях новее протестированной.
Следить стоит за тем, даст ли общая модель Good Start Labs, обученная на экспертных моделях для отдельных игр, прирост за пределами игровых сценариев. Даффи говорит, что цель — объединить эти экспертные модели в общий игровой интеллект, применимый везде. Если такая модель улучшит результаты на задачах, не связанных ни с одной игрой, подход станет обычной строкой в бюджетах на обучение ИИ; если прирост останется внутри структурно похожих задач, это останется инструментом для узких проверяемых процессов.
