
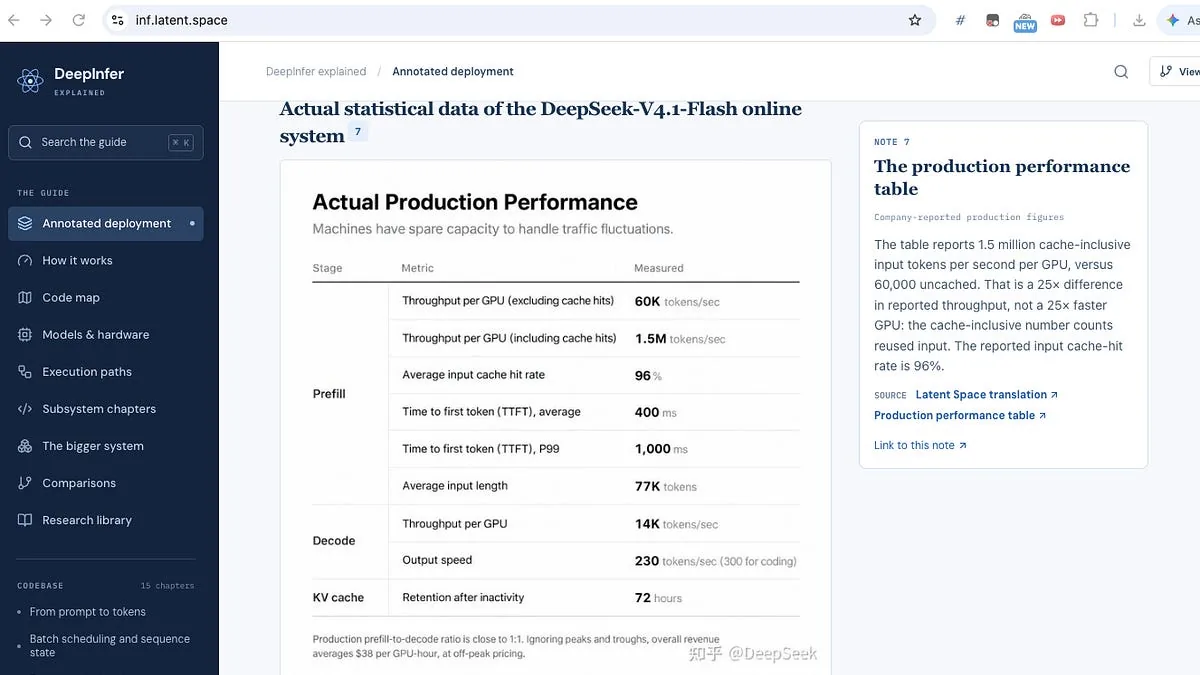
DeepSeek открыла исходный код DeepInfer, стека инференса модели V4.1 Flash, и раскрыла производственные показатели одного кластера: 155 трлн токенов в день при 96% попаданий входных запросов в кэш. Компания заявляет о среднем времени до первого токена 400 мс и скорости генерации 230 токенов в секунду, а для программирования — 300 токенов в секунду. При внепиковых тарифах выручка оценивается в $38 на ускоритель в час, и это важно, поскольку превращает инференс из центра затрат в операцию с высокой маржой.
Как DeepInfer обслуживает V4.1 Flash
DeepInfer поддерживает распределенный инференс, спекулятивное декодирование, SWA Bounded Replay и структурированный вывод на платформах NVIDIA и Huawei Ascend. Компонент deepseek-recipe отвечает за промышленное кодирование и декодирование токенов и обработку, совместимую с официальным API. DeepSeek обещает публиковать в этом же репозитории реализации инференса будущих моделей. Выпуск приурочен к PyTorch Conf и описан как доработка vLLM с опорой на наработки SGLang и TRTLLM.
Архитектура разделяет кодирование изображений, prefill и decode, чтобы каждая стадия масштабировалась под собственное узкое место. Рекомендуемая конфигурация — машины с восемью ускорителями для prefill и суперузлы на 64–128 ускорителей для decode с широким expert-параллелизмом для распределения MoE-экспертов. Планировщик prefill распределяет работу по оценочной стоимости attention-вычислений, а не по длине запроса, подбирая переменный размер чанков под бюджет времени. Маршрутизация decode учитывает число активных запросов и накопленную длину KV-кэша, а асинхронное планирование на CPU убирает простои между шагами декодирования.
Иерархия кэша объясняет значительную часть заявленной пропускной способности. Постоянный блочный KV хранится в отдельном кластере 3FS емкостью около 100 PiB на SSD, со сроком хранения три дня для агентского трафика и семь дней для чат-ботов. Поскольку кэшированные префиксы находятся в общем хранилище, запрос может обрабатывать любой свободный prefill-воркер, а не тот, что обслуживал префикс ранее. Такая схема удобна для агентов, многократно пересылающих растущую историю инструкций, содержимого репозитория, выводов инструментов и прошлых ответов. Популярные эксперты также реплицируются и периодически перераспределяются для сокращения ожидания из-за перекоса маршрутизации.
Что экономика кэшированных токенов меняет для бизнеса
Для компаний, использующих агентов и ассистентов, практический эффект — снижение стоимости выполненной задачи при повторяющихся промптах. Производственные данные из отчета указывают на 1,5 млн входных токенов с учетом кэша в секунду на GPU prefill и 14 000 выходных токенов в секунду на GPU decode при парке около 2400 GPU. Внепиковые тарифы указаны на уровне $0,15 за миллион входных токенов и $0,60 за миллион выходных токенов. Крупные установки со стабильным агентским трафиком выиграют больше всего, а небольшие компании с разнородными запросами получат меньшую экономию от кэширования.
Ограничения заслуживают не меньшего внимания при выборе решения. Несмотря на характеристику «полностью открытый код», управление KV-кэшем и балансировка нагрузки пока раскрыты не полностью, поскольку связаны с внутренней инфраструктурой. Показатели 155 трлн токенов, маржа выше 80% при полной стоимости $5–8 на карту в час и окупаемость за 81 день — это заявления самой компании, а не независимо проверенные измерения. Команда vLLM сообщила о пропускной способности декодирования в пределах 6% от DeepInfer на GB200 при сопоставимой конфигурации, поэтому эффективность сама по себе не доказывает уникальность стека. Покупателям следует уточнять состав учтенных затрат и порядок учета попаданий в кэш при биллинге токенов.
Индикатором подтверждения тренда станут воспроизведение и внедрение за пределами DeepSeek. Если независимые команды повторят сравнение с vLLM и опубликуют стабильные рецепты для prefill на восьми GPU и крупных decode-суперузлов, обслуживание кэшированных префиксов станет стандартным требованием при закупках. Если хранение три–семь дней окажется экономичным на коммерческом хранилище, вендоры будут конкурировать сроком жизни кэша, а не чистой скоростью в токенах в секунду.
