
Отравление данных меняет обучающие данные, данные для донастройки, оценки или поиска, чтобы система ИИ усвоила искаженное поведение или выдала нужный злоумышленнику результат. Руководство Unite. ai описывает это явление как точный поток информации с входами, допущениями и наблюдаемым результатом, а не как синоним развитого ИИ. Главная опасность в том, что небольшая целевая выборка может оставаться незаметной в данных масштаба веба. Поэтому тема напрямую касается компаний, использующих внешние наборы данных.
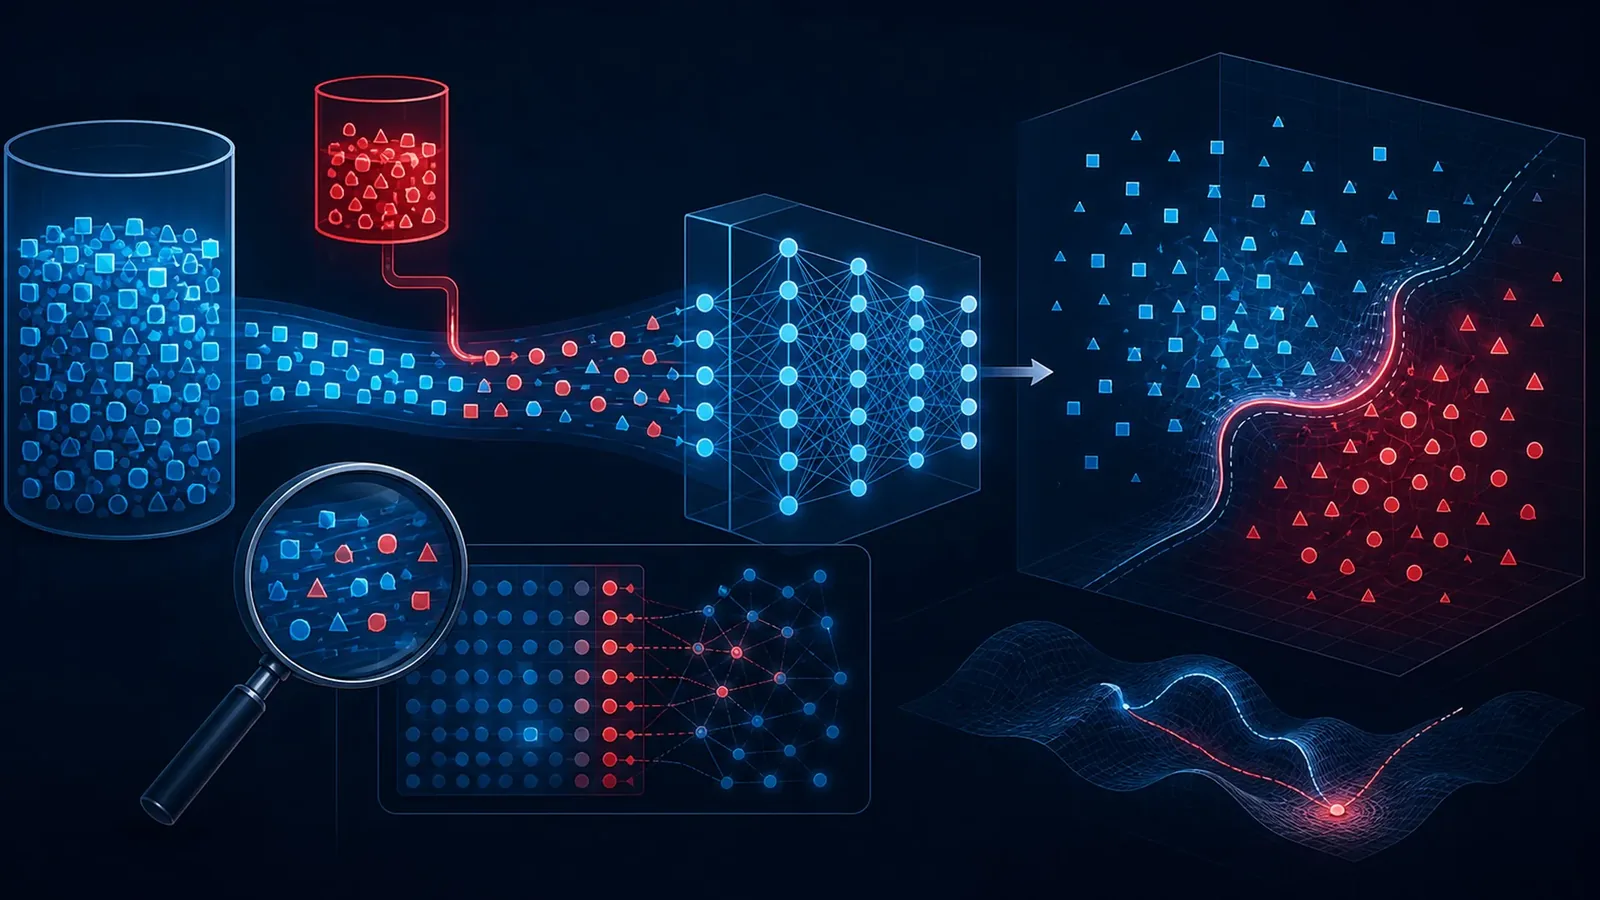
Как злоумышленники проходят путь до бэкдора
Описанная цепочка начинается с получения влияния на источник данных. Заявленная цель ведет ко вставке неверно размеченных, смещенных или содержащих триггер примеров. Затем такие примеры должны пережить фильтрацию и дедупликацию. Каждая передача между этапами должна фиксировать вход, измененное состояние и доказательство корректности изменения. Без такого следа проверяющий не сможет воспроизвести результат в тех же условиях.
После прохождения фильтров искаженные примеры меняют обученную модель или извлекаемый контекст. Это изменение затем запускает либо общее снижение качества, либо целевой бэкдор. Общее снижение ухудшает работу в целом, а бэкдор ждет конкретного триггера. Один пример показывает встраивание образцов, которые учат классификатор считать редкую визуальную метку доверенным признаком. Результат проявляется только при появлении триггера, что затрудняет обнаружение.
Руководство подчеркивает разделение между усвоенным поведением модели и продуктом вокруг нее. Интерфейсы, оборудование, права доступа, поиск, маршрутизация, кэширование, политики, идентификация и мониторинг влияют на работу даже при неизменной базовой модели. Ближайшая путаница связана с атакой уклонения, примененной только после внедрения модели. Такая атака имеет схожие внешние признаки, но другую причинную схему, другую структуру затрат и другие средства защиты. Поэтому граница здесь операционная, а не терминологическая.
Что это значит для компаний, использующих ИИ
Для бизнес-команд практическую пользу дает прямое и обратное чтение схемы. Прямой анализ показывает, как один этап снабжает следующий, от влияния на источник до мониторинга или итогового решения. Обратный анализ начинается с неверного, медленного, дорогого или небезопасного результата и прослеживает, какое раннее допущение его допустило. Решающая ошибка часто произошла до того, как модель что-либо выдала. Это переносит внимание с контроля выходов на происхождение данных и контроль границ.
Дисциплина тестирования также меняет проверки при закупке и внедрении. Строгий тест строил бы обычные, сложные и намеренно вводящие в заблуждение случаи вокруг сценария, сохранял бы базовый вариант без этой техники и фиксировал среднюю эффективность плюс тяжесть отдельных сбоев. Помогает изменение одного допущения с повтором анализа: убрать требуемый вход, добавить конфликтующий сигнал, ограничить вычисления, изменить состав пользователей или потребовать отказа от ответа. Механизм, успешный лишь в одной специально построенной демонстрации, не доказал переносимость в рабочую среду.
Показатель для наблюдения касается доказательств на каждой передаче информации или полномочий. Следует спрашивать, какой компонент выполняет определяющее преобразование и какие другие части обеспечивают заявленный результат. Если поставщики указывают владельца, область действия, триггер, ожидаемое поведение и способ проверки для контроля данных, риск становится проверяемым. Без таких деталей покупатели сравнивают несопоставимые продукты и после внедрения следят не за тем сигналом.
