
SerpApi добавил Markdown-вывод во все свои 100+ API поисковых данных без дополнительной платы: в одном тесте один поиск Google по запросу «coffee» занял 24,723 токена в JSON и 6,435 токенов в Markdown. Снижение на 74% фиксирует более широкий сдвиг в инфраструктуре: данные в формате, на котором обучались модели, стоят дешевле в обработке. Для компаний, чьи агенты ежедневно загружают результаты поиска, формат ответа API теперь напрямую влияет на лимиты контекста и расходы на инференс.
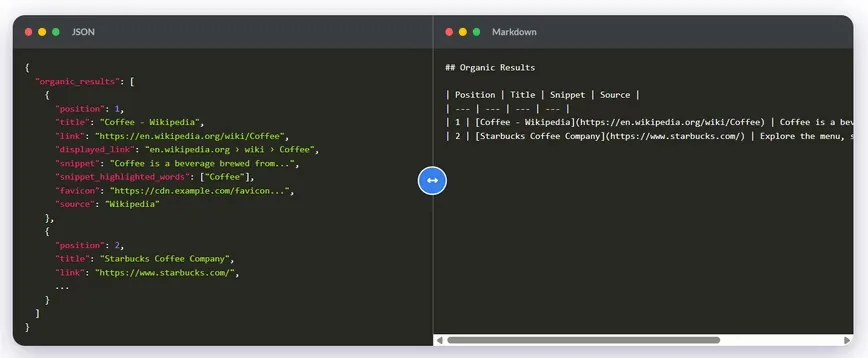
Как работает опция Markdown
SerpApi, девятилетний поставщик поисковых данных для разработчиков, исследователей и компаний из Fortune 500, собирает структурированные данные из Google, Bing, YouTube и других источников. Разработчики теперь могут запрашивать те же результаты в легком Markdown вместо JSON без перехода на новый эндпоинт. Опция включается добавлением output=md в строку запроса, вызовом маршрута /search. md или заголовком Accept: text/markdown. Ответы содержат YAML frontmatter для метаданных, структурированные таблицы Markdown для выборок и встроенные ссылки, готовые для вставки в промпты или память агента.
Экономия достигается за счет удаления того, что моделям не нужно для рассуждений. JSON-выдача поиска несет редирект-ссылки, favicon, параметры отслеживания, глубоко вложенные метаданные и дублирующиеся поля, которые раздувают число токенов без пользы для решений. Markdown-вывод сохраняет заголовки, фрагменты, ссылки, цены и рейтинги в списках и таблицах, убирая шум отслеживания и дубли. В примере с «coffee» фильтрация полей поверх Markdown снизила ответ далее до 1,298 токенов. По всему каталогу SerpApi сообщает о средней экономии примерно 50%, а на отдельных эндпоинтах — до 90%.
Изменение опирается на то, как модели учатся и как чат-интерфейсы показывают ответы. Большие языковые модели, обученные на сайтах документации, README-файлах, технических блогах, форумах и базах знаний, уже разбирают заголовки, списки, таблицы и блоки кода как смысловые сигналы, а не шум. Чат-интерфейсы отображают Markdown чисто без дополнительной конвертации, поэтому модель, которая получает Markdown и отвечает в Markdown, остается в едином контуре. Документация OpenAI по промпт-инжинирингу советует тот же подход: двойные знаки решетки для крупных разделов, маркированные списки, таблицы и обратные кавычки для кода. Сторонние руководства повторяют совет для сложных промптов, особенно для новых моделей серии GPT-5, при этом за JSON сохраняется роль программной обработки и строгого контроля схемы.
Что дешевый контекст дает командам ИИ
Для продуктовых команд прямой эффект — больше полезного контекста на запрос при меньших затратах. API поиска, электронной торговли, карт и контента дают самые шумные данные для агентов, поэтому среднее сокращение на 50% позволяет агенту изучить больше результатов в том же окне или выполнить больше циклов поиска за тот же бюджет. Небольшая компания с одним агентом поддержки или исследования продаж получает ниже стоимость задачи и меньше обрывов по лимиту. Крупная структура с тысячами поисков в день через источники Google, Bing и YouTube превращает ту же экономию в прирост пропускной способности инференса и скорости ответов.
Компромисс — в выборе формата под этап работы. Markdown подходит для фазы загрузки контекста, когда агенту нужны заголовки, фрагменты и рейтинги для рассуждения, а JSON остается надежнее там, где код должен проверять поля, контролировать типы или обновлять учетные системы. Покупателям следует проверить, какие поля убираются в режиме Markdown, как YAML frontmatter ложится на текущие парсеры и сохраняют ли агентные фреймворки таблицы и ссылки без повторного раздувания. Сам по себе запуск не доказывает рост точности и не отменяет проверку качества выдачи, задержек и обработки ошибок на живых запросах.
Маркером станет повторение опыта. Если в ближайшие месяцы больше поставщиков данных поиска, торговли, карт и контента добавят варианты Markdown, а агентные фреймворки стандартизируют разделы и таблицы Markdown для найденного контекста, формат перейдет из оптимизации в норму. Следом появятся инструменты замера токенного следа. Без такого распространения это останется полезной опцией для активных пользователей поиска, а не стандартом инфраструктуры.
