
Исследователи Манчестерского университета адаптировали открытые AI-модели NVIDIA Earth-2 для прогнозирования загрязнения воздуха по всей Великобритании и получили общенациональную модель загрязнения с разрешением 2-3 кв. км. Обучение заняло два дня на одном узле с восемью GPU суперкомпьютера Isambard-AI в Бристоле. Значение работы в том, что загрязнение воздуха, по оценкам, стало причиной 30 000 смертей в Британии за прошлый год, а детальные прогнозы до сих пор ограничивала стоимость вычислений.
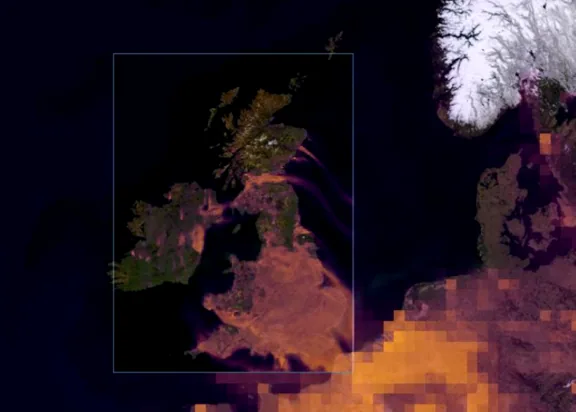
Что построила команда из Манчестера
Проект возглавил Дэвид Топпинг, профессор факультета наук о Земле и окружающей среде университета. Отправной точкой стало наблюдение, что семейство открытых моделей и инструментов NVIDIA Earth-2 уже решило сопоставимую задачу для прогнозирования погоды. Топпинг с коллегами сгенерировали обучающие данные из существующих химико-климатических симуляций и обучили Earth-2 CorrDiff — генеративную модель даунскейлинга — на Isambard-AI, национальном AI-суперкомпьютере Британии. Затем команда добавила Earth-2 StormCast — модель, которая позволяет строить прогнозы с учётом времени, напрямую используя наблюдения за качеством воздуха. Для переобучения модели под загрязнение использовали год британских данных о загрязнении, симулированных с часовыми интервалами.
Isambard-AI описывается как самый мощный AI-суперкомпьютер Британии: 5 448 суперчипов NVIDIA GH200 Grace Hopper с производительностью 21 эксафлопс в AI-задачах. Модель загрязнения обучали на одном узле этой системы с восемью GPU. Саймон Макинтош-Смит, директор Бристольского центра суперкомпьютеров при Бристольском университете и сооснователь Isambard-AI, отметил, что расход GPU-часов оказался относительно низким, а значит, на выполнение нагрузок ушло меньше энергии суперкомпьютера. Тот же рабочий процесс работает и на настольной AI-системе DGX Spark на суперчипе NVIDIA GB10 Grace Blackwell — для инференса и небольших обучающих запусков; теперь одна такая система стоит в офисе Топпинга для переобучения моделей.
Что это значит для бизнеса
Практическое следствие — меняется круг тех, кто может строить детальные прогнозы загрязнения. Топпинг заявляет целью открыть обучающие данные и рабочие процессы, чтобы аналогичные модели можно было обучать для других стран и регионов, с намерением, чтобы каждая страна и каждый крупный город при небольшом запасе времени на суперкомпьютере могли построить собственную детальную модель загрязнения на локальных данных. Для крупной организации это снижает порог входа с инфраструктуры национального масштаба до одного узла или настольной системы. Для небольшой команды важнее другое: Топпинг оценивает стартовые вложения в несколько тысяч долларов на разработку мощных AI-моделей.
Прежде чем такие модели начнут влиять на операционные решения, нужно проверить несколько вещей. Текущее разрешение 2-3 кв. км — ещё не масштаб улицы; команда планирует его повысить, добавив дополнительные открытые данные. Прогнозы обучены на симулированных химико-климатических данных, поэтому точность по сравнению с реальными наблюдениями — первый вопрос, который стоит проверить заказчику или государственному ведомству. Сценарий для здравоохранения, который описывает Топпинг, — предупреждения пациентам с астмой о высоком загрязнении завтра или на следующей неделе — зависит от доступа к наблюдениям за качеством воздуха, который, по словам команды, пока ограничен. Ещё одно направление — связка модели загрязнения с edge AI-устройствами для приёма данных в реальном времени и поддержки решений, например при лесных пожарах.
Ниалл Робинсон, менеджер по связям с разработчиками в области погоды и климата в NVIDIA, назвал двухдневное обучение и возможность запускать модель на DGX Spark изменением того, кто может заниматься этой наукой и как быстро. Хао Чжан, докторант Манчестерского университета, обучивший StormCast на Isambard-AI, отметил как заметную часть работы лёгкость переключения между фреймворками NVIDIA. На горизонте пяти лет Топпинг описывает агентный интерфейс, в котором врач или госорган задаёт вопрос, а цепочка моделей возвращает ответ, опирающийся на лежащую в основе науку.
Ориентир для наблюдения — публикация открытых обучающих данных и рабочих процессов. Если другие страны и города обучат на них собственные модели загрязнения на локальных данных, подход станет воспроизводимым шаблоном, а не единичным исследовательским результатом; если публикация задержится или модели не совпадут с наблюдаемым уровнем загрязнения, ценность для бизнеса останется теоретической.
