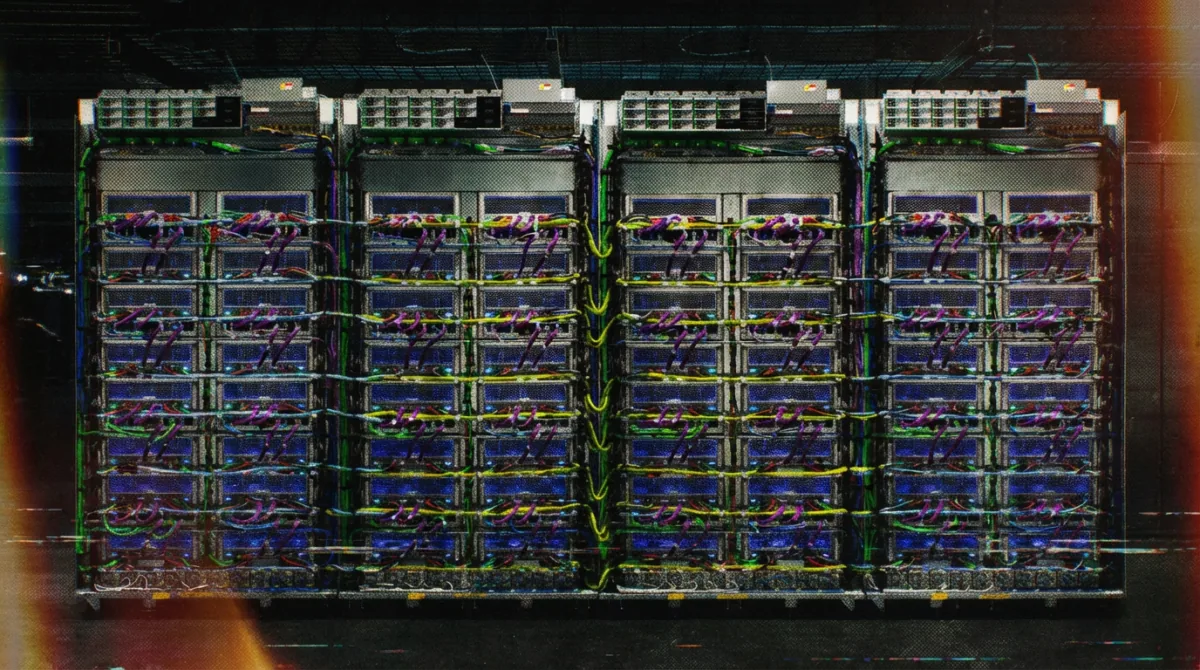
Google расширила линейку ускорителей восьмого поколения моделями TPU 8tx для конфиденциальных вычислений и TPU 8i Max для задач с высокой нагрузкой на память. Компания заявила, что впервые поставила четыре системы TPU в течение одного года. Оба варианта используют существующий кристалл с другой компоновкой, сетью и конфигурацией памяти. Это важно, потому что Google превращает собственные чипы в широкую платформу для внешних заказчиков.
Два новых варианта на существующем кристалле
TPU 8tx и TPU 8i Max не открывают новое поколение чипов. Google описывает их как системные конфигурации на основе того же процессора с изменениями в упаковке, сети и подсистеме памяти. Компания называет такой модульный подход осознанным решением, которое сокращает выпуск аппаратных вариантов до месяцев вместо лет. Именно такой темп объясняет появление четырех систем за двенадцать месяцев. Число внешних клиентов TPU достигло почти 100, что закрепляет переход от внутреннего инструмента к рыночной платформе.
TPU 8tx создан для предприятий и государственных организаций, работающих с чувствительными данными. Обычно данные шифруются при хранении и передаче, но расшифровываются в памяти во время обработки, и Google заявляет, что новый вариант закрывает этот разрыв. Данные и веса моделей остаются защищенными и изолированными даже при активном использовании. В системе применяется сеть Boardfly с низкой задержкой, разработанная для инференса в реальном времени. Google обещает до двукратного снижения задержки по сравнению с TPU 8t, а у Nvidia уже есть сопоставимая архитектура конфиденциальных вычислений для GPU.
TPU 8i Max решает проблему пропускной способности памяти для агентов, работающих с большими кодовыми базами или многочасовым видео. Google разместила два чипа TPU 8i в одном корпусе, чтобы убрать это узкое место. В итоге вычислительная мощность, объем памяти и пропускная способность памяти удвоены в том же стоечном формате. Такое сочетание повышает производительность на квадратный метр площади центра обработки данных. В части ПО Google открыла исходный код TorchTPU для запуска кода PyTorch с минимальными изменениями и добавила поддержку vLLM и SGLang.
Что это значит для корпоративных покупателей ИИ
Для компаний, использующих инференс, расширение линейки увеличивает выбор за пределами облаков на GPU. TPU 8tx позволяет выполнять дообучение моделей, дистилляцию больших моделей в компактные и обучение ИИ-агентов методом обучения с подкреплением в одной системе без переноса чувствительных данных между кластерами. TPU 8i Max подходит для работы с длинным контекстом, где пропускная способность памяти ограничивает скорость, включая анализ кода и видео. Небольшие компании получают доступ к специализированным мощностям без строительства кластеров, а крупные могут лучше использовать площадь стоек.
Перед переносом нагрузок покупателям следует проверить соответствие решений своим задачам. Для конфиденциальных вычислений важны управление ключами, гарантии изоляции и признание регуляторами при работе с регулируемыми данными. Производительность в задачах с высокой нагрузкой на память зависит от пропускной способности в реальном коде, а не только от удвоенных характеристик в той же стойке. Совместимость ПО тоже требует тестирования, несмотря на поддержку TorchTPU, vLLM и SGLang. Сам по себе этот выпуск не доказывает более низкую стоимость или быстрое внедрение по сравнению с решениями Nvidia, Amazon, Microsoft и OpenAI.
Показателем успеха станет внешнее внедрение в течение 2026 года. Если число сторонних клиентов TPU заметно превысит почти 100, а фреймворки инференса покажут стабильную работу в production, модульная стратегия подтвердит себя. Nvidia ответила сделкой с Groq по найму команды и лицензированию, поэтому ориентиром станет производительность инференса у конкурентов. Влияние на бизнес проявится в доступной мощности и скорости развертывания.