
Anthropic выпустила Claude Opus 5.5 — первую модель нового семейства Claude 5.5, которая по большинству задач работает на уровне Claude Fable 5.1 и обходится на 40% дешевле в эксплуатации, чем Opus 5. Редакция AINews, раздела Latent Space, сразу объявила о переходе на Opus 5.5 после сравнения выдачи с GPT-6 Sol. Это важно, потому что модель сразу стала моделью по умолчанию в Claude Code и приложении Claude, включая Cowork, и переход происходит без настройки.
Что изменилось в модели и её ценах
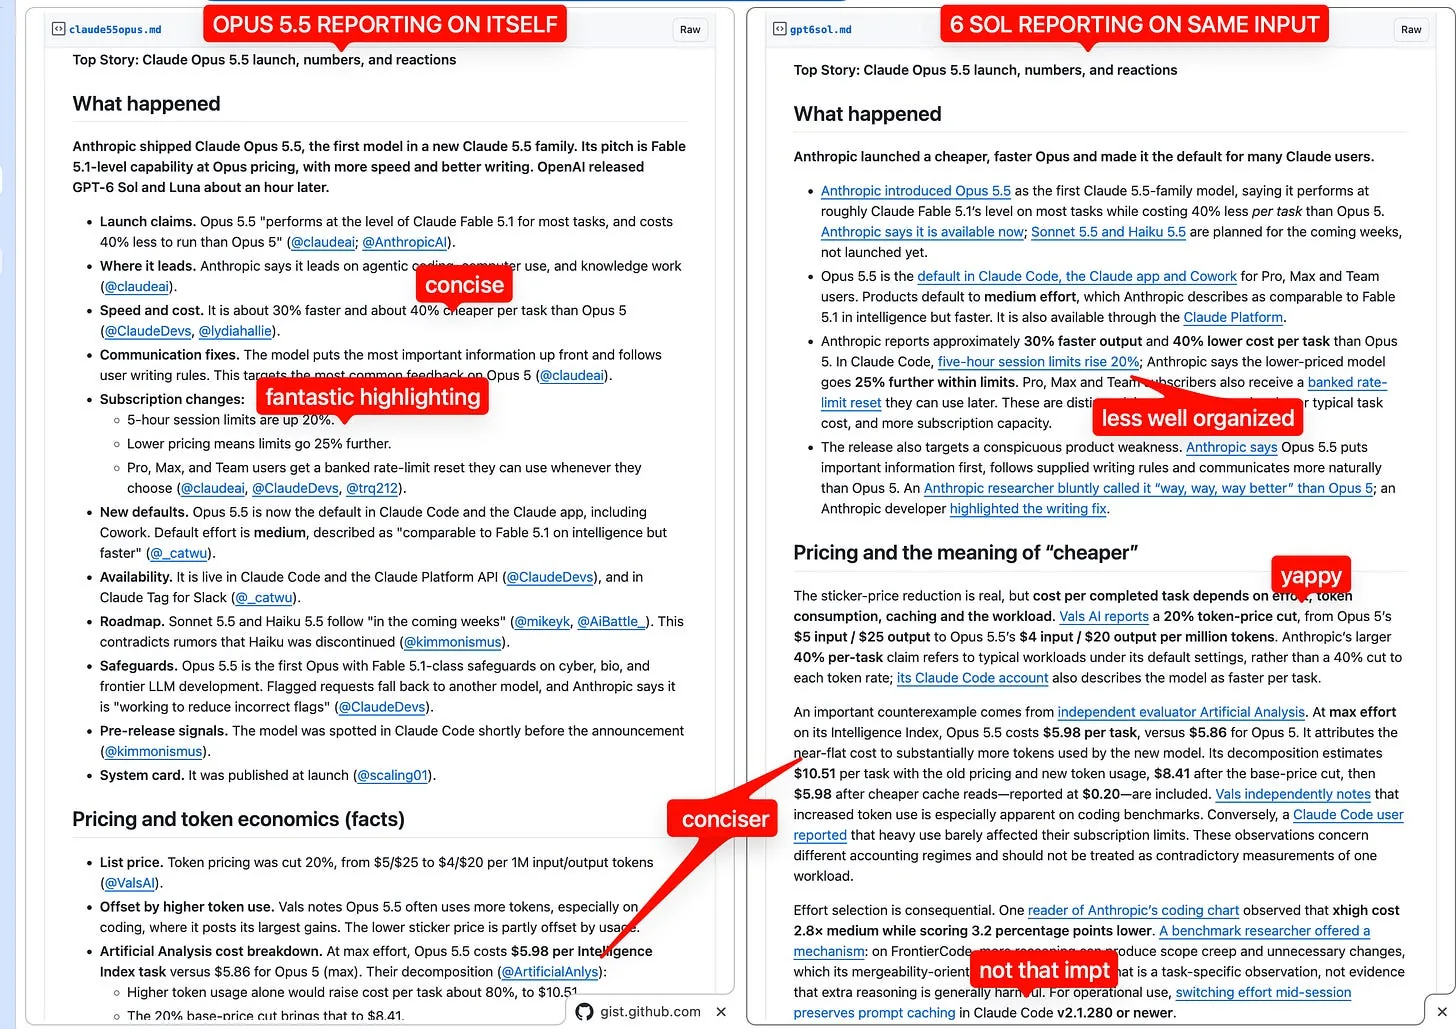
Ценник на токены снизился на 20% — с $5/$25 до $4/$20 за 1M токенов входа и выхода, а стоимость задачи упала примерно на 40% относительно Opus 5 при росте скорости около 30%. Anthropic заявляет лидерство в agentic coding, computer use и knowledge work, а собственная таблица сравнения показывает Opus 5.5 впереди Fable 5.1 по каждой строке и впереди GPT-6 Astra по большинству. На CursorBench модель набирает 57.8% на Max effort и занимает первое место, тратя на задачу на 40% меньше, чем Opus 5; на FrontierCode 1.1 результат 65.3% на Extended забирает первое место у Fable 5. Sonnet 5.5 и Haiku 5.5 обещаны в ближайшие недели, что опровергает прежние слухи о снятии Haiku с производства.
Под капотом выигрыш даёт работа над эффективностью на этапах prefill, decode и общих вычислений — именно этим Anthropic и OpenAI объясняли свои снижений цен после запуска GPT-6 Sol и Luna на 50% ниже GPT-5.6. Artificial Analysis разбирает реальную экономику: на max effort Opus 5.5 стоит $5.98 за задачу Intelligence Index против $5.86 у Opus 5, поскольку только рост расхода токенов поднял бы стоимость задачи примерно на 80%, до $10.51, и лишь более дешёвые чтения кэша по $0.20 это компенсируют. Обещанные 40% экономии действуют на стандартном effort medium, а выгода по стоимости задачи исчезает на max. Cline сообщает, что Opus 5.5 обходит Fable 5.1 по Intelligence Index примерно в 2.5 раза дешевле, а смена effort в середине сессии не ломает prompt caching в Claude Code начиная с версии v2.1.280.
Запуск случился на плотном фоне: OpenAI примерно через час выпустила GPT-6 Sol и Luna со ценами на 50% ниже GPT-5.6, и обе лаборатории связали снижение цен с ростом эффективности. Anthropic в первый же день опубликовала системную карту, включая раздел 8.12 о масштабировании до 100 параллельных агентов, который комментаторы назвали первым подобным отчётом лаборатории. Меры безопасности доведены до уровня Fable 5.1 по кибер-, био- и frontier LLM development, а запросы под флагом переключаются на другую модель. Сэм Боуман из Anthropic заявил, что выпуск Opus 5.5 с большей вероятностью снижает риски несоответствия намерений, чем увеличивает их, а Майк Кригер указал на объёмные проверки выравнивания, включая внешнюю оценку от METR.
Что это меняет для команд, внедряющих AI
Для компаний, запускающих агентов в проде, прямой эффект — счёт ниже при прежнем качестве: стандартный effort medium даёт интеллект уровня Fable 5.1 примерно на 40% дешевле по задаче, а скидка 20% на цену токенов действует на каждый запрос. Выигрывают больше всего небольшие команды, которые почти не настраивают effort и работают на дефолте, а крупным организациям с тяжёлой нагрузкой на кодирование нужно сверять экономику с фактическим расходом токенов: по данным Vals, Opus 5.5 часто тратит больше токенов именно там, где приросты максимальны. Модель также выносит ключевую информацию в начало и соблюдает правила оформления, заданные пользователем, — это прямой ответ на самую частую претензию к Opus 5 в длинных сессиях.
Перед сменой вендора есть что проверить. На max effort экономия по задаче относительно Opus 5 исчезает, а на одном графике agentic coding effort xhigh стоит примерно в 2.8 раза дороже medium при результате на 3.2 пункта ниже, поэтому уровень effort стоит фиксировать осознанно. Результат ProgramBench почти в 100% построен на подмножестве 166 из 200 задач, где, скорее всего, нет самых сложных программ вроде FFmpeg и компилятора PHP, а частичные решения с 60–70% пройденных тестов раздувают метрику. На диаграммах и вёрстке ParseBench модель по-прежнему слаба, а при цене 5.8 цента за страницу LlamaIndex называет её слишком дорогой для промышленного OCR — оценка от вендора с конкурирующим продуктом. Остаётся проблема ложных срабатываний: один пользователь ушёл на резервную модель после безобидного запроса, и Anthropic признаёт, что работает над снижением ошибочных флагов.
Главный маркер для наблюдения — выход Sonnet 5.5 и Haiku 5.5 в ближайшие недели: если более дешёвые уровни придут с той же профилью эффективности, снижение цен распространится на всю линейку Claude и изменит шорт-лист вендоров для проектов на агентах. Если же экономия держится только на medium, а стоимость на max остаётся прежней, закупкам стоит трактовать цифру 40% как характеристику дефолтных настроек, а не как строку бюджета.
